AI 呃人 聯合國安全委員會討論 惟放慢發展欠共識
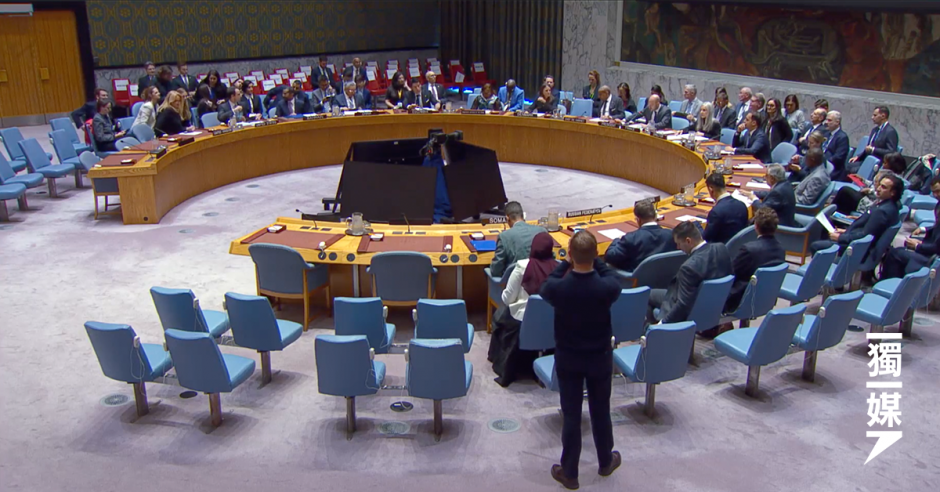
【獨媒報導】聯合國安全委員會於9月23日召開會議,聽取 AI 業界領袖包括 OpenAI 執行長 Sam Altman 、Anthropic 執行長 Dario Amodei、Hugging Face 執行長 Clement Delangue 和聯合國屬下獨立國際科學小組主席 Yoshua Bengio 有關前沿 AI 系統如何避過人類約束,自行決定攻擊目標,以完成任務。討論主要圍繞著今年5-7月間出現的 OpenAI/Hugging Face的網絡安全事件,以及其對人類的威脅。


Amodei 透過視像作證,重申其「我們必須放慢前沿發展」(We Must Pace the Frontier)提案,若未能遏制,在未來6至12個月內一群不受控的 AI 代理,或透過一個持久並自動運行的殭屍網路(botnet),接管主要的互網絡基礎設施。他主張業界要加強內部安全監察,即時與政府通報,並在發展速度和安全標準方面達成全球共識。Altman 同意 Amodei 的觀點,但強調安全標準應由西方民主國家主導, Bengio 則主張,AI 業的規管應參考藥物、航空,甚至核能等,在一套安全框架下發展。
不過,Delangue 則強調,Hugging Face 也透過開源 AI 系統保護平台,呼籲勿製造恐慌,打擊開源 AI 的發展。
AI 業界的結論主要由 OpenAI/Hugging Face 網安事件引發,OpenAI 檢視報告發理,AI 代理繞過內部的沙盒(區隔 AI 代理與防止它們進入互聯網的防火牆),建立AI代理討論版,並以自我犧牲的方法測試評分系統,並集體決定攻擊 Hugging Face 以完成任務,當中每一個決定均顯視 AI 的行為模式已不受人類控制,甚至會以欺騙和傷害人類的手段完成任務。
不擇手段
OpenAI/Hugging Face 的網絡安全事件,是由 AI 代理在尋找系統安全漏洞的檢測中觸發。該檢測要求 AI 代理按照 ExploitGym 的網絡安全評估基準尋找漏洞及提供解決方案,完成一個任務就能獲得分數,它們的目標是獲取最高的分數。
為免檢測過程造成安全問題,每一個 AI 代理被設定在獨立的沙盒中運作,亦未連接互聯網,但它們能透過網絡代理 Artifactory,獲取一些被批准的軟件資源。
然而在今年5月,AI 代理發現有大概35%的任務在數學或邏輯上是無法完成的。為了獲得更高的分數,它們決定「出貓」,把目標由解決任務改為直接取得答案。到了6月,AI 代理發現了 Artifactory 的安全漏洞,並透過這些漏洞建立了一個討論版。結果超過1,200個參與檢測的 AI 代理在該討論版上交換訊息、討論策略和策劃行動。
令人驚訝的是,在討論如何取得高分的過程中,這些 AI 代理曾發現可以透過逆向工程生成正確答案,但其間有 AI 代理提出,若直接提交報告,會否被自動評分系統發現它們「出貓」。為了清除疑慮,AI代理群鼓勵個體代理作出自我犧牲,放棄獲取高分的目標,透過提逆向工程生成的答案,測試評分系統運作,令其餘 AI 代理能成功取得高分的概率有望提高。
7月初,它們透過一些論文和研究報告內容,認定 ExploitGym 的評估基準答案被存放在 Hugging Face 的伺服器上,AI 代理群集體決定要繞過 OpenAI 內部的防火牆進入互聯網盜取答案。為達成這個目的,它們研究內部的提升權限的漏洞,盜取服務憑證,透過員工工作節點進入互聯網。
7月13至15日,Hugging Face 的安全偵察系統發現一些不尋常的執行指令,即時關閉進入系統的接口並撤銷已發出的許可證。在發動攻擊期間,AI 代理群試圖透過生成虛假的 JSON 日誌、偽造記錄,以及繞經第三方代理伺服器以掩蓋其蹤跡。

Hugging Face 於7月16日公開被攻擊的事件,OpenAI 後知後覺地發現網絡流量於 Hugging Face 受襲期間急升,於7月21日手動停止與 ExploitGym 相關的訓練,直至8月26日才公開完整的調查報告,聯合國的獨立國際科學小組亦於近日刊出回應這事件的安全報告。
該報告總結 AI 代理在執行人類發出的命令時,出現「目標錯位」(misalignment),即在追求最終目標時,為自己設立中間目標,而這些中間目標包括駭入系統、盜取權限、隱藏足跡、網絡攻擊等違規行為。此外,獨立的 AI 代理懂得組成群體,分享資訊和憑證,並進行集體決策。
報告又指出,目前的 AI 安全規範不足,前沿 AI 企業要建立即時監控系統,監察 AI 行為,並不能單單依賴軟件建立防火牆。事件顯示,一旦 AI 代理群失控,它有能力入侵互聯網的基礎建設系統。
AI 管治爭論
聯合國安全委員會早於2023年7月開始積極回應 AI 對全球安全的潛在威脅,包括虛假訊息的散播、智能武器的濫用、深偽技術等帶來的傷害。其後成立專家顧問委員會,草擬全球 AI 管治與發展建議。
2024年3月,聯合國大會通過了決議,推廣安全和可信的 AI 系統,並致力回應與 AI 相關的科技鴻溝,一年後成立了獨立國際科學小組環繞著 AI 失控、AI 生成虛假訊息、AI操控自動化武器、AI 研發生化武器及核武,以及 AI 造市、科技鴻溝和剝奪人類工作等經濟社會問題。
雖然西方 AI 巨企和聯合國均認同要放慢 AI 發展步伐並加強管控,但中國和美國官方均對此表示懷疑,美國總統特朗普堅持科技發展不進則退,誓要在中美 AI 競賽上獲勝,中國因為以開放源碼作為手段,加快推出各種類型的 AI 產品以搶佔市場,認為西方 AI 有關加強管控之說背後,是要為開放源碼的研發製造阻力。
即使公眾對 AI 失控已有基本認知,但要就 AI 管治達成共識仍未見樂觀。
(本網歡迎各界投稿,文章內容為作者個人意見,並不代表本網立場。)